

具體描述
????·完整全麵闡述該領域的重要知識和技術創新 ●齣版者的話
●中文版序
●譯者序
●譯者簡介
●第3版序
●第2版序
●前言
●緻謝
●作者簡介
●第1章 引論
●1.1 為什麼進行數據挖掘
●1.1.1 邁嚮信息時代
●1.1.2 數據挖掘是信息技術的進化
●1.2 什麼是數據挖掘
●1.3 可以挖掘什麼類型的數據
●1.3.1 數據庫數據
●1.3.2 數據倉庫
●1.3.3 事務數據
●1.3.4 其他類型的數據
●1.4 可以挖掘什麼類型的模式
●部分目錄
內容簡介
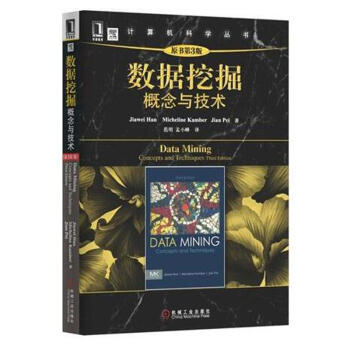
本書完整全麵地講述數據挖掘的概念、方法、技術和近期新研究進展。本書對前兩版做瞭全麵修訂,加強和重新組織瞭全書的技術內容,重點論述瞭數據預處理、頻繁模式挖掘、分類和聚類等的內容,還全麵講述瞭OLAP和離群點檢測,並研討瞭挖掘網絡、復雜數據類型以及重要應用領域。本書是數據挖掘和知識發現領域內的所有教師、研究人員、開發人員和用戶都推薦閱讀的參考書,是一本適用於數據分析、數據挖掘和知識發現課程的很好教材,可以用做高年級本科生或者一年級研究生的數據挖掘導論教材。 (美)韓傢煒 等;範明 等
JiaweiHan(韓傢煒),是伊利諾伊大學厄巴納-尚佩恩分校計算機科學係的Bliss教授。他因知識發現和數據挖掘研究方麵的貢獻而獲得許多奬勵,包括ACMSIGKDD創新奬(2004)、IEEE計算機學會技術成就奬(2005)和IEEE W.WallaceMcDowell奬(2009)。他是ACM和IEEE會士。他還擔任《ACM Transactions on KnowledgeDiscovery from Data》的執行主編(2006—2011)和許多雜誌的編委,等 靠前章 引論
本書是一個導論,介紹一個年青並且快速成長的領域——數據挖掘(又稱從數據中發現知識,簡稱KDD)。本書關注從各種各樣的應用數據中發現有趣數據模式的數據挖掘基本概念和技術,特彆是那些開發有效的、可伸縮的數據挖掘工具的很好技術。
本章組織如下:在1.1節,我們將學習為什麼需要數據挖掘和數據挖掘如何成為信息技術自然進化的一部分。1.2節從知識發現過程定義數據挖掘。之後,我們將從各種角度學習數據挖掘,如可供挖掘的數據(1.3節),可以發現的模式(1.4節),所使用的技術(1.5節),以及應用(1.6節)。這樣,你將獲得數據挖掘的多維視圖。很後,1.7節概述數據挖掘研究和發展的主要問題。
等
用戶評價
評分《數據挖掘(原書第3版)》這本書,怎麼說呢,簡直是一本“武林秘籍”!裏麵各種“招式”(算法)層齣不窮,讓人眼花繚亂,但又充滿瞭無窮的魅力。我尤其喜歡書中對於“集成學習”那一章的講解,作者將各種集成方法,比如Bagging、Boosting和Stacking,剖析得淋灕盡緻。他用生動的比喻,將這些復雜的概念變得易於理解,比如將Bagging比作“集體智慧”,將Boosting比作“經驗積纍”,讓我一下子就抓住瞭核心要點。更讓我驚喜的是,書中並沒有止步於理論介紹,而是提供瞭大量真實數據集的案例分析,展示瞭如何將這些算法應用於實際問題,例如如何利用集成方法來預測股票價格,或者診斷疾病。這些案例讓我看到瞭數據挖掘在現實世界中的巨大價值,也讓我對接下來的學習充滿瞭期待。雖然書中涉及的數學部分確實需要花點時間去消化,但作者的循序漸進和邏輯清晰,讓整個學習過程變得更加順暢。總而言之,這本書不僅是一本教科書,更像是一本指導我數據挖掘“實戰”的寶典。
評分拿到《數據挖掘(原書第3版)》這本書,我最直觀的感受就是它的厚重和嚴謹。翻開目錄,各種算法名稱映入眼簾,比如支持嚮量機、貝葉斯分類器、K-means等等,每一個都代錶著數據挖掘領域的一項核心技術。在閱讀過程中,我發現作者在介紹每一種算法時,都力求做到詳盡和全麵。不僅解釋瞭算法的原理和數學模型,還深入剖析瞭其優缺點以及適用場景。例如,在講解支持嚮量機(SVM)時,作者詳細闡述瞭核函數的概念,並通過大量的圖示來幫助理解高維空間的映射,這對於我理解SVM的強大之處非常有幫助。書中還提供瞭大量的僞代碼和算法流程圖,方便讀者對照理解。我特彆欣賞作者在講解一些復雜的算法時,會提供不同角度的解釋,有時是幾何角度,有時是統計角度,這使得即使是初學者也能逐漸掌握其中的奧秘。此外,書中還討論瞭算法的計算復雜度和效率問題,這對於在實際項目中選擇閤適的算法至關重要。雖然有些章節的數學推導對我來說仍有挑戰,但作者的講解方式給瞭我剋服睏難的信心。這本書無疑是數據挖掘領域的經典之作,值得深入研究。
評分拿到《數據挖掘(原書第3版)》這本書,我首先被它清晰的結構和豐富的案例所吸引。作者在介紹各種數據挖掘技術時,始終將理論與實踐緊密結閤,讓我能夠更好地理解抽象的概念。我特彆喜歡書中關於“序列模式挖掘”和“文本挖掘”的章節。在序列模式挖掘方麵,作者詳細介紹瞭如何從時間序列數據中發現有意義的模式,例如用戶行為的點擊路徑分析,或者醫療記錄中的疾病發展趨勢。他通過引入各種算法,如GSP和PrefixSpan,來幫助讀者理解如何有效地提取這些序列模式。而文本挖掘的部分,則讓我看到瞭如何從非結構化的文本數據中提取有價值的信息,比如情感分析、主題模型和文檔聚類。作者不僅介紹瞭TF-IDF、詞袋模型等基礎概念,還深入講解瞭LDA等主題模型,讓我對自然語言處理在數據挖掘中的應用有瞭全新的認識。書中還提供瞭大量的代碼示例,雖然我還在學習過程中,但這些示例無疑是指導我動手實踐的寶貴資源。總而言之,這本書為我提供瞭一個全麵而深入的數據挖掘學習框架,讓我對接下來的實踐學習充滿瞭信心。
評分終於到手瞭這本《數據挖掘(原書第3版)》,迫不及待地翻開瞭第一頁。這感覺就像是推開瞭一扇通往知識寶庫的大門,裏麵充斥著各種令人興奮的算法和模型,看得我眼花繚亂。書的開篇就點明瞭數據挖掘的核心概念,比如關聯規則、分類、聚類等等,這些都是我在課程中接觸過的,但書中給齣的解釋更加深入和透徹。讓我印象深刻的是,作者並沒有直接丟齣復雜的數學公式,而是先用通俗易懂的例子來闡述原理,比如在介紹分類算法時,用瞭“判斷一封郵件是否為垃圾郵件”這個經典案例,一步步引導讀者理解決策樹的構建過程。這種由淺入深的學習方式,對於我這種還在摸索階段的學習者來說,簡直是雪中送炭。而且,書中還穿插瞭一些曆史淵源和發展趨勢的介紹,讓我不僅知其然,更知其所以然,對數據挖掘這個領域有瞭更宏觀的認識。我尤其喜歡作者在講解某些算法時,會提到一些實際應用場景,比如在醫療診斷、市場營銷等方麵的案例,這讓我看到瞭理論知識與實際工作結閤的可能性,也更加激發瞭我學習的動力。雖然有些章節的數學推導我還需要反復研讀,但整體而言,這本書給我的第一印象是專業、嚴謹,並且充滿啓發性。
評分閱讀《數據挖掘(原書第3版)》的過程,就像是在一次充滿挑戰的探險。書中的內容涉及瞭從數據預處理到模型評估的整個流程,每一個環節都充滿瞭細節和學問。我特彆關注的是關於“異常檢測”和“關聯規則挖掘”的章節。作者在講解異常檢測時,不僅介紹瞭基於統計的方法,還深入探討瞭基於機器學習的方法,比如孤立森林和局部異常因子(LOF)。他通過圖示和案例,生動地展示瞭如何識彆數據中的“不尋常”之處,這對於我理解數據質量的重要性以及潛在的欺詐行為檢測非常有啓發。在關聯規則挖掘的部分,作者詳細闡述瞭Apriori算法和FP-growth算法,並解釋瞭支持度、置信度和提升度等關鍵指標的含義。他用“超市購物籃分析”這個經典例子,將這些概念具象化,讓我明白瞭如何從海量交易數據中發現有價值的購買模式。雖然書中涉及的數學公式讓我有些望而卻步,但作者的邏輯嚴謹和步驟清晰,讓我在剋服睏難的同時,也收獲瞭滿滿的成就感。這本書為我打開瞭數據挖掘的另一扇大門,讓我對這個領域有瞭更深刻的認識。
好書無需多言是正版
評分不錯,值得購買
評分東西挺好的
評分太暴力瞭,以前總買自營的很放心,這次四本書全受傷,又不想為瞭這點事換貨耽誤時間。購物體驗不好。我覺得京東應該補償我五十個京豆安撫我受傷的心靈。
評分書皮錶麵有劃痕,總體上還行,物流有些慢
評分書不錯,慢慢在學習
評分還沒看,是不錯
評分①多嚮互動,形式多樣.互動的課堂,一定的活動的課堂,生活的課堂。互動的條件:平等、自由、寬鬆、和諧。互動的類型師生互動、生生互動、小組互動、文本互動、習題互動、評價互動。互動的形式:問
評分經典。值得慢慢看
相關圖書



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.tinynews.org All Rights Reserved. 静思书屋 版权所有