

具体描述
????·完整全面阐述该领域的重要知识和技术创新 ●出版者的话
●中文版序
●译者序
●译者简介
●第3版序
●第2版序
●前言
●致谢
●作者简介
●第1章 引论
●1.1 为什么进行数据挖掘
●1.1.1 迈向信息时代
●1.1.2 数据挖掘是信息技术的进化
●1.2 什么是数据挖掘
●1.3 可以挖掘什么类型的数据
●1.3.1 数据库数据
●1.3.2 数据仓库
●1.3.3 事务数据
●1.3.4 其他类型的数据
●1.4 可以挖掘什么类型的模式
●部分目录
内容简介
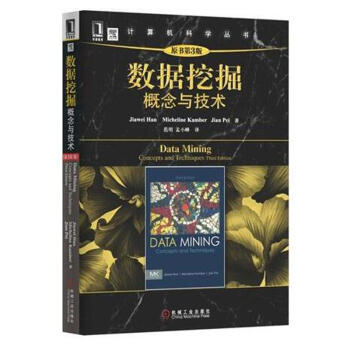
本书完整全面地讲述数据挖掘的概念、方法、技术和近期新研究进展。本书对前两版做了全面修订,加强和重新组织了全书的技术内容,重点论述了数据预处理、频繁模式挖掘、分类和聚类等的内容,还全面讲述了OLAP和离群点检测,并研讨了挖掘网络、复杂数据类型以及重要应用领域。本书是数据挖掘和知识发现领域内的所有教师、研究人员、开发人员和用户都推荐阅读的参考书,是一本适用于数据分析、数据挖掘和知识发现课程的很好教材,可以用做高年级本科生或者一年级研究生的数据挖掘导论教材。 (美)韩家炜 等;范明 等
JiaweiHan(韩家炜),是伊利诺伊大学厄巴纳-尚佩恩分校计算机科学系的Bliss教授。他因知识发现和数据挖掘研究方面的贡献而获得许多奖励,包括ACMSIGKDD创新奖(2004)、IEEE计算机学会技术成就奖(2005)和IEEE W.WallaceMcDowell奖(2009)。他是ACM和IEEE会士。他还担任《ACM Transactions on KnowledgeDiscovery from Data》的执行主编(2006—2011)和许多杂志的编委,等 靠前章 引论
本书是一个导论,介绍一个年青并且快速成长的领域——数据挖掘(又称从数据中发现知识,简称KDD)。本书关注从各种各样的应用数据中发现有趣数据模式的数据挖掘基本概念和技术,特别是那些开发有效的、可伸缩的数据挖掘工具的很好技术。
本章组织如下:在1.1节,我们将学习为什么需要数据挖掘和数据挖掘如何成为信息技术自然进化的一部分。1.2节从知识发现过程定义数据挖掘。之后,我们将从各种角度学习数据挖掘,如可供挖掘的数据(1.3节),可以发现的模式(1.4节),所使用的技术(1.5节),以及应用(1.6节)。这样,你将获得数据挖掘的多维视图。很后,1.7节概述数据挖掘研究和发展的主要问题。
等
用户评价
阅读《数据挖掘(原书第3版)》的过程,就像是在一次充满挑战的探险。书中的内容涉及了从数据预处理到模型评估的整个流程,每一个环节都充满了细节和学问。我特别关注的是关于“异常检测”和“关联规则挖掘”的章节。作者在讲解异常检测时,不仅介绍了基于统计的方法,还深入探讨了基于机器学习的方法,比如孤立森林和局部异常因子(LOF)。他通过图示和案例,生动地展示了如何识别数据中的“不寻常”之处,这对于我理解数据质量的重要性以及潜在的欺诈行为检测非常有启发。在关联规则挖掘的部分,作者详细阐述了Apriori算法和FP-growth算法,并解释了支持度、置信度和提升度等关键指标的含义。他用“超市购物篮分析”这个经典例子,将这些概念具象化,让我明白了如何从海量交易数据中发现有价值的购买模式。虽然书中涉及的数学公式让我有些望而却步,但作者的逻辑严谨和步骤清晰,让我在克服困难的同时,也收获了满满的成就感。这本书为我打开了数据挖掘的另一扇大门,让我对这个领域有了更深刻的认识。
评分终于到手了这本《数据挖掘(原书第3版)》,迫不及待地翻开了第一页。这感觉就像是推开了一扇通往知识宝库的大门,里面充斥着各种令人兴奋的算法和模型,看得我眼花缭乱。书的开篇就点明了数据挖掘的核心概念,比如关联规则、分类、聚类等等,这些都是我在课程中接触过的,但书中给出的解释更加深入和透彻。让我印象深刻的是,作者并没有直接丢出复杂的数学公式,而是先用通俗易懂的例子来阐述原理,比如在介绍分类算法时,用了“判断一封邮件是否为垃圾邮件”这个经典案例,一步步引导读者理解决策树的构建过程。这种由浅入深的学习方式,对于我这种还在摸索阶段的学习者来说,简直是雪中送炭。而且,书中还穿插了一些历史渊源和发展趋势的介绍,让我不仅知其然,更知其所以然,对数据挖掘这个领域有了更宏观的认识。我尤其喜欢作者在讲解某些算法时,会提到一些实际应用场景,比如在医疗诊断、市场营销等方面的案例,这让我看到了理论知识与实际工作结合的可能性,也更加激发了我学习的动力。虽然有些章节的数学推导我还需要反复研读,但整体而言,这本书给我的第一印象是专业、严谨,并且充满启发性。
评分拿到《数据挖掘(原书第3版)》这本书,我最直观的感受就是它的厚重和严谨。翻开目录,各种算法名称映入眼帘,比如支持向量机、贝叶斯分类器、K-means等等,每一个都代表着数据挖掘领域的一项核心技术。在阅读过程中,我发现作者在介绍每一种算法时,都力求做到详尽和全面。不仅解释了算法的原理和数学模型,还深入剖析了其优缺点以及适用场景。例如,在讲解支持向量机(SVM)时,作者详细阐述了核函数的概念,并通过大量的图示来帮助理解高维空间的映射,这对于我理解SVM的强大之处非常有帮助。书中还提供了大量的伪代码和算法流程图,方便读者对照理解。我特别欣赏作者在讲解一些复杂的算法时,会提供不同角度的解释,有时是几何角度,有时是统计角度,这使得即使是初学者也能逐渐掌握其中的奥秘。此外,书中还讨论了算法的计算复杂度和效率问题,这对于在实际项目中选择合适的算法至关重要。虽然有些章节的数学推导对我来说仍有挑战,但作者的讲解方式给了我克服困难的信心。这本书无疑是数据挖掘领域的经典之作,值得深入研究。
评分《数据挖掘(原书第3版)》这本书,怎么说呢,简直是一本“武林秘籍”!里面各种“招式”(算法)层出不穷,让人眼花缭乱,但又充满了无穷的魅力。我尤其喜欢书中对于“集成学习”那一章的讲解,作者将各种集成方法,比如Bagging、Boosting和Stacking,剖析得淋漓尽致。他用生动的比喻,将这些复杂的概念变得易于理解,比如将Bagging比作“集体智慧”,将Boosting比作“经验积累”,让我一下子就抓住了核心要点。更让我惊喜的是,书中并没有止步于理论介绍,而是提供了大量真实数据集的案例分析,展示了如何将这些算法应用于实际问题,例如如何利用集成方法来预测股票价格,或者诊断疾病。这些案例让我看到了数据挖掘在现实世界中的巨大价值,也让我对接下来的学习充满了期待。虽然书中涉及的数学部分确实需要花点时间去消化,但作者的循序渐进和逻辑清晰,让整个学习过程变得更加顺畅。总而言之,这本书不仅是一本教科书,更像是一本指导我数据挖掘“实战”的宝典。
评分拿到《数据挖掘(原书第3版)》这本书,我首先被它清晰的结构和丰富的案例所吸引。作者在介绍各种数据挖掘技术时,始终将理论与实践紧密结合,让我能够更好地理解抽象的概念。我特别喜欢书中关于“序列模式挖掘”和“文本挖掘”的章节。在序列模式挖掘方面,作者详细介绍了如何从时间序列数据中发现有意义的模式,例如用户行为的点击路径分析,或者医疗记录中的疾病发展趋势。他通过引入各种算法,如GSP和PrefixSpan,来帮助读者理解如何有效地提取这些序列模式。而文本挖掘的部分,则让我看到了如何从非结构化的文本数据中提取有价值的信息,比如情感分析、主题模型和文档聚类。作者不仅介绍了TF-IDF、词袋模型等基础概念,还深入讲解了LDA等主题模型,让我对自然语言处理在数据挖掘中的应用有了全新的认识。书中还提供了大量的代码示例,虽然我还在学习过程中,但这些示例无疑是指导我动手实践的宝贵资源。总而言之,这本书为我提供了一个全面而深入的数据挖掘学习框架,让我对接下来的实践学习充满了信心。
评分高深实用高深实用
评分包装的很好,价格也合理,好评
评分学习了
评分很受用,学习充电中,喜欢
评分印刷和包装不错,应该是正版。只是书本身的翻译有点儿生硬。
评分书很好
评分上课用买的,还不错,值得买
评分沟通中达成共识。
评分这次购书很满意!
相关图书



本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等
© 2026 book.tinynews.org All Rights Reserved. 静思书屋 版权所有