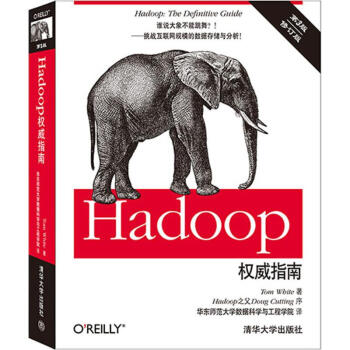

Hadoop权威指南(第3版,修订版)

Hadoop权威指南(第3版,修订版) pdf epub mobi txt 电子书 下载 2026

☆☆☆☆☆
TomWhite 著
图书标签:
  • Hadoop
  • 大数据
  • 分布式存储
  • 分布式计算
  • MapReduce
  • YARN
  • HDFS
  • 数据分析
  • 云计算
  • Java
想要找书就要到 静思书屋
立刻按 ctrl+D收藏本页
你会得到大惊喜!!
店铺: 文轩网旗舰店
出版社: 清华大学出版社
ISBN:9787302370857
商品编码:1389587095
出版时间:2015-01-01

具体描述

作  者:(美)Tom White;东师范大学数据科学与工程学院 定  价:99 出 版 社:清华大学出版社 出版日期:2015年01月01日 页  数:679 装  帧:平装 ISBN:9787302370857

?? 新版新特色,内容更,更适合收藏和找Hadoop之父签名儿!

????? 广受好评的《Hadoop指南(第2版 修订版)》的升级版《Hadoop指南(第3版)》来啦!

●第1章 初识Hadoop 1
●1.1 数据!数据! 1
●1.2 数据的存储与分析 3
●1.3 相较于其他系统的优势 4
●1.3.1 关系型数据库管理系统 5
●1.3.2 网格计算 7
●1.3.3 志愿计算 9
●1.4 Hadoop发展简史 10
●1.5 Apache Hadoop和Hadoop生态系统 14
●1.6 Hadoop的发行版本 15
●1.6.1 本书包含的内容 16
●1.6.2 兼容性 17
●第2章 关于MapReduce 19
●2.1 气象数据集 19
●2.2 使用Unix工具来分析数据 21
●2.3 使用Hadoop来分析数据 23
●2.3.1 map和reduce 23
●2.3.2 Java MapReduce 24
●2.4 横向扩展 33
●2.4.1 数据流 34
●部分目录

内容简介

准备好释放数据的强大潜能了吗?借助于这本《Hadoop指南》,你将学习如何使用Apache Hadoop构建和维护稳定性高、伸缩性强的分布式系统。本书是为程序员写的,可帮助他们分析任何大小的数据集。本书同时也是为管理员写的,帮助他们了解如何设置和运行Hadoop集群。本书通过丰富的案例学习来解释Hadoop的幕后机理,阐述了Hadoop如何解决现实生活中的具体问题。第3版覆盖Hadoop的近期新动态,包括新增的MapReduce API,以及MapReduce 2及其灵活性更强的执行模型(YARN)。 (美)Tom White;东师范大学数据科学与工程学院 Tom White,数学王子&Hadoop;专家。身为Apache Hadoop提交者八年之久,Apache软件基金会成员之一。优选知名云计算公司Cloudera的软件工程师。Tom拥有英国剑桥大学数学学士学位和利兹大学科学哲学硕士学位。     初识Hadoop

    在古时候,人们用牛来拉重物。当一头牛拉不动一根圆木时,人们从来没有考虑过要培育更强壮的牛。同理,我们也不该想方设法打造不错计算机,而应该千方百计综合利用更多计算机来解决问题。
    ——格蕾斯·霍珀(Grace Hopper)
    1.1 数据!数据!
    我们生活在这个数据大爆炸的时代,很难估算优选电子设备中存储的数据总共有多少。靠前数据公司(IDC)曾经发布报告称,2006年数字世界(digital universe)项目统计得出优选数据总量为0.18 ZB并预测在等

大数据时代的基石:Hadoop生态系统深度解析与实践 在这个数据爆炸式增长的时代,如何有效地存储、处理和分析海量数据,已成为企业能否在激烈的市场竞争中脱颖而出的关键。Apache Hadoop,作为开源分布式计算框架的翘楚,凭借其强大的可伸缩性、容错性和经济性,已经成为大数据处理领域事实上的标准。本书并非您所提及的《Hadoop权威指南(第3版,修订版)》,而是一本聚焦于Hadoop生态系统中核心组件的深度解析与实战应用指南,旨在为读者构建一个全面、扎实的大数据技术体系。 我们深知,Hadoop的魅力远不止于HDFS(Hadoop分布式文件系统)和MapReduce(分布式计算模型)。它是一个庞大而活跃的生态系统,包含了众多相互协作、各司其职的组件,共同支撑着端到端的大数据解决方案。本书将带领您循序渐进地探索这个精彩的世界,从底层原理到上层应用,从理论概念到实践操作,力求为大数据从业者、技术爱好者以及希望深入理解大数据技术的读者提供一份详实且富有洞察力的参考。 一、 数据存储的基石:HDFS的精髓与演进 任何大数据处理的首要环节都是数据的存储。HDFS作为Hadoop的核心组件之一,以其分布式、高吞吐量、可容错的设计,完美契合了存储海量数据的需求。本书将深入剖析HDFS的架构设计,包括NameNode、DataNode、Secondary NameNode等关键角色的职责与协作机制。我们将详细阐述文件的块(Block)存储策略、副本(Replication)机制如何保障数据的可靠性,以及NameNode的元数据管理、文件系统的命名空间(Namespace)如何组织海量文件。 此外,我们还将探讨HDFS在版本演进过程中引入的诸多重要特性,例如HDFS Federation(联合),它能够解决单个NameNode的性能瓶颈和单点故障问题,实现跨多个HDFS集群的统一管理。对于 Namenode 的高可用性(High Availability)方案,如 Active/Standby 模式,我们也会进行详尽的介绍,分析其工作原理、故障转移过程以及相关的配置细节。读者将了解到如何根据实际业务需求,对HDFS进行精细化的配置和优化,以达到最佳的存储性能和可用性。 二、 计算引擎的革新:MapReduce到Spark的飞跃 MapReduce作为Hadoop的经典计算模型,其“Map”和“Reduce”的范式革新了大规模并行计算的思路。本书将首先深入讲解MapReduce的工作原理,包括JobTracker、TaskTracker的角色,任务的调度与执行流程,以及Shuffle与Sort阶段的关键技术。我们会通过生动的例子,演示如何将复杂的计算问题分解为Map和Reduce任务,并指导读者编写高效的MapReduce程序。 然而,随着大数据处理需求的日益复杂化和时效性要求的提高,传统的MapReduce在迭代计算和交互式查询方面表现出明显的局限性。Spark的出现,凭借其内存计算的优势,极大地提升了数据处理的速度和效率。本书将重点介绍Apache Spark的核心概念,包括RDD(弹性分布式数据集)的设计思想、DAG(有向无环图)调度器的工作原理,以及Spark SQL、Spark Streaming、MLlib(机器学习库)和GraphX(图计算库)等组件的功能与应用。我们将详细阐述Spark如何通过在内存中缓存中间数据,实现比MapReduce快10到100倍的计算性能。 对于Spark的部署模式,包括Standalone、YARN以及Mesos,我们也会进行详细的分析和比较,帮助读者根据不同的场景选择最合适的部署方案。通过丰富的代码示例和实践指导,读者将能够熟练掌握Spark的API,并能够利用Spark解决各种复杂的数据处理挑战。 三、 数据管理与分析的利器:Hive、HBase与ZooKeeper 在大数据领域,数据的组织、管理和查询同样至关重要。Apache Hive将SQL查询语言引入Hadoop生态系统,使得熟悉SQL的分析师能够轻松地对存储在HDFS上的海量数据进行结构化查询,极大地降低了大数据分析的门槛。本书将深入解析Hive的架构,包括Hive Metastore(元数据存储)、HiveServer2,以及其SQL到MapReduce/Spark的转换过程。我们将介绍Hive的数据模型(表、分区、分桶),以及各种文件格式(如TextFile, SequenceFile, ORC, Parquet)对性能的影响。读者将学会如何设计高效的Hive表结构,编写优化的HiveQL查询,并利用Hive进行OLAP(联机分析处理)等操作。 对于需要实时数据访问和随机读写的场景,Apache HBase应运而生。 HBase是一个构建在HDFS之上的分布式、面向列的NoSQL数据库。本书将详细讲解HBase的数据模型(行键、列族、列限定符、时间戳),以及其底层存储机制(HFile, MemStore, WAL)。我们将介绍HBase的Master Server、RegionServer的职责,以及数据Region的划分与负载均衡。读者将了解如何设计HBase的表结构,掌握其CRUD(创建、读取、更新、删除)操作,并了解其在实时推荐、物联网数据采集等场景下的应用。 Apache ZooKeeper是Hadoop生态系统中不可或缺的分布式协调服务。它为分布式应用提供了统一的命名服务、状态同步服务以及分布式锁等功能。本书将深入分析ZooKeeper的架构,包括Leader-Follower模型、ZAB(ZooKeeper Atomic Broadcast)协议,以及其在Hadoop HA(高可用)机制中的关键作用。我们将解释ZooKeeper是如何实现 Namenode 的高可用,以及它如何在其他分布式组件(如Kafka, HBase)中提供协调服务。 四、 数据集成与流式处理:Sqoop、Flume与Kafka 在实际的大数据应用中,将关系型数据库中的数据导入Hadoop,以及将实时产生的数据流入Hadoop进行处理,是常见的需求。Apache Sqoop是连接关系型数据库与Hadoop的桥梁,它能够高效地将数据从RDBMS导入HDFS,或将HDFS中的数据导出到RDBMS。本书将详细介绍Sqoop的使用方法,包括数据导入、导出、增量同步等操作,并分析其性能优化技巧。 Apache Flume是一个用于高效收集、聚合和传输大量日志数据的分布式服务。本书将解析Flume的Agent架构(Source, Channel, Sink),并演示如何利用Flume构建日志收集管道,将各种来源的日志数据实时地传输到HDFS或其他存储系统中。 对于需要处理实时流式数据的场景,Apache Kafka已经成为事实上的标准。Kafka作为一个分布式发布-订阅消息系统,以其高吞吐量、低延迟和持久化的特性,为实时数据处理提供了强大的支撑。本书将深入讲解Kafka的核心概念,包括Producer、Consumer、Broker、Topic、Partition等,以及Kafka的消费者群组(Consumer Group)、偏移量(Offset)管理机制。我们将探讨Kafka的容错与伸缩性设计,并演示如何利用Kafka构建高可用的实时数据流处理管道。 五、 数据处理与可视化:Oozie、Pig与商业智能工具 在复杂的Hadoop工作流中,任务的调度、依赖管理和监控变得至关重要。Apache Oozie是一个用于管理Hadoop Job(MapReduce, Pig, Hive, Spark等)的工作流调度系统。本书将介绍Oozie的工作流(Workflow)、协调(Coordination)和 uçuş (Bundle) 的概念,并指导读者如何使用Oozie来定义、调度和监控复杂的大数据处理任务。 Apache Pig是另一个用于数据分析的高级抽象层,它提供了一种名为Pig Latin的脚本语言,可以简化MapReduce程序的编写。本书将介绍Pig Latin的语法和常用函数,并展示如何利用Pig对HDFS上的数据进行探索性数据分析。 最后,为了让数据分析的价值得以最大化地体现,数据可视化至关重要。本书将简要介绍一些主流的商业智能(BI)工具,如Tableau、Power BI,以及开源的可视化工具(如Superset、Metabase),并探讨它们如何与Hadoop生态系统集成,实现对海量数据的交互式探索和可视化呈现。 结语 本书并非对《Hadoop权威指南(第3版,修订版)》的直接替代,而是提供了一个从Hadoop核心组件到关键生态系统工具的全面而深入的视角。我们力求通过清晰的讲解、翔实的案例和丰富的实践指导,帮助读者掌握Hadoop及其生态系统的精髓,能够独立地设计、构建和运维大数据平台,从而在瞬息万变的数据浪潮中,抓住机遇,实现数据价值的最大化。无论您是初涉大数据领域的新手,还是希望深化技术理解的资深从业者,本书都将是您在大数据探索之旅中不可或缺的伙伴。

用户评价

评分☆☆☆☆☆

作为一个长期在学术界进行大数据研究的学生,我对Hadoop的理解通常更侧重于理论层面。然而,理论知识的掌握并不能完全等同于实际应用的能力。《Hadoop权威指南(第3版,修订版)》在这方面给予了我很大的启发。书中在阐述理论的同时,非常注重实践环节,提供了大量的代码示例和配置指导,这让我能够更容易地将课堂上学到的知识转化为实际操作。例如,书中关于如何搭建Hadoop集群的详细步骤,以及如何利用Hive进行数据分析的教程,都让我受益匪浅。我特别喜欢书中对于一些高级特性的介绍,比如Hadoop的高可用性配置、安全性管理以及跨平台集成等,这些内容对于深入研究和开发高性能的大数据应用至关重要。这本书的严谨性和全面性,让我能够从一个更宏观的视角来审视Hadoop在现代数据架构中的地位,并且为我未来的研究方向提供了宝贵的参考。

评分☆☆☆☆☆

我是一个对新技术充满好奇心,并且乐于动手实践的IT爱好者。在学习Hadoop的过程中,我遇到过不少瓶颈,主要是在于如何将学到的知识应用到实际项目中。这本书恰恰解决了我的这个痛点。《Hadoop权威指南(第3版,修订版)》不仅仅是一本讲解Hadoop技术的书,更像是一本教会你如何“使用Hadoop”的指南。书中有很多关于如何解决实际大数据处理难题的案例分析,这让我能够从别人的经验中学习,避免走弯路。我印象深刻的是,书中针对一些常见的Hadoop集群部署问题,提供了详细的排查思路和解决方案,这对我来说是无价的。而且,书中还介绍了Hadoop生态中一些新兴的技术和发展趋势,让我能够保持对行业前沿的敏感度。阅读这本书,我感觉自己不仅仅是在学习一个技术,更是在学习一种解决复杂数据问题的思维方式。这本书的实用性和前瞻性,让我觉得物超所值。

评分☆☆☆☆☆

我是一个有着几年分布式系统开发经验的工程师,在工作中接触过不少大数据相关的技术。虽然之前也有一些Hadoop的基础知识,但总感觉不够系统,对整个生态的理解存在一些模糊的认识。这本书恰好填补了我的这些知识盲点。作者在书中并没有仅仅停留在API的介绍,而是深入剖析了Hadoop各个组件的设计哲学和内部原理。比如,在讲解HDFS的容错机制时,书中对NameNode和DataNode的协同工作、副本机制、数据块管理等都做了非常细致的描述,这让我对HDFS的健壮性有了更深刻的认识。同样,对于MapReduce的执行流程、Shuffle过程、JobTracker和TaskTracker的角色,书中也提供了详尽的解释。我尤其欣赏作者在书中引入了一些性能调优的技巧和注意事项,这对于实际生产环境中的应用非常有指导意义。总而言之,这本书的深度和广度都非常符合我作为一名资深开发者的需求,它帮助我将零散的知识点串联起来,形成了一个完整的Hadoop知识体系,极大地提升了我对大数据处理技术的理解能力。

评分☆☆☆☆☆

这本书真是让我大开眼界!作为一个刚刚接触大数据领域的新人,我一直被Hadoop这个庞大的生态系统搞得晕头转向。市面上相关的书籍也不少,但很多都显得过于理论化,或者年代久远,跟不上技术发展的步伐。直到我翻开了《Hadoop权威指南(第3版,修订版)》,那种豁然开朗的感觉简直太美妙了。书中的讲解层层递进,从Hadoop最核心的概念,比如HDFS和MapReduce,到更高级的应用,如YARN、Hive、HBase等等,都做了深入浅出的阐述。我尤其喜欢作者在介绍每一个组件时,都会结合实际的应用场景,这让我能够清晰地理解这些技术是如何解决实际问题的,而不是仅仅停留在抽象的概念层面。而且,书中给出的代码示例也非常实用,我可以直接在自己的环境里复现,并且根据自己的需求进行修改和扩展。阅读这本书的过程,就像是跟着一位经验丰富的向导,一步一步地穿越Hadoop的丛林,最终到达彼岸。我感觉自己不再是被动的接受信息,而是主动地去探索和学习,这种学习体验让我非常满意。

评分☆☆☆☆☆

坦白说,在读这本书之前,我对Hadoop的印象就是一个“慢”和“复杂”的代名词。市面上很多关于Hadoop的书籍,要么充斥着晦涩难懂的术语,要么就停留在概念的堆砌,让我觉得望而却步。但《Hadoop权威指南(第3版,修订版)》彻底改变了我的看法。作者用一种非常平易近人的方式,将Hadoop这个看似庞大的技术体系拆解开来,并且用生动的比喻和丰富的图示,将原本枯燥的原理变得栩栩如生。我印象最深的是在讲解MapReduce的设计模式时,作者用一个简单的例子,就清晰地展示了各种模式的应用场景和优劣势。这让我不再觉得MapReduce是一个难以掌握的工具,反而觉得它是一种非常强大的数据处理范式。而且,书中对Hadoop生态中各个组件的联动关系也做了清晰的梳理,比如YARN如何统一管理计算资源,Hive如何提供SQL接口,HBase如何实现低延迟的数据访问等等,这些都让我对整个大数据处理流程有了更清晰的认识。这本书就像是为我点亮了一盏指路明灯,让我能够自信地走近Hadoop。

评分☆☆☆☆☆

专业书籍,慢慢看,价格实惠,就是没包邮

评分☆☆☆☆☆

书还在看 内容很丰富 省着看官网了

评分☆☆☆☆☆

书很好,内容很细致,但是感觉不太适合初学者快速上手

评分☆☆☆☆☆

内容充实,知识点丰富!

评分☆☆☆☆☆

很喜欢的一本书

评分☆☆☆☆☆

质量很好,包装也很好。

评分☆☆☆☆☆

经典巨著,活动低价,物美价廉

评分☆☆☆☆☆

书质量还可以,学习中。。。。

评分☆☆☆☆☆

有点深奥,最好自己搞个linux实际操作一下

相关图书
本站所有内容均为互联网搜索引擎提供的公开搜索信息,本站不存储任何数据与内容,任何内容与数据均与本站无关,如有需要请联系相关搜索引擎包括但不限于百度,google,bing,sogou 等

© 2026 book.tinynews.org All Rights Reserved. 静思书屋 版权所有